精准溯源,一“测”即明!-岛津eMSTAT Solution软件机器学习结合LCMS-TQ RX系列对大米代谢产物分析和产地区分
发布时间:2026-03-12 阅读次数:426次
您是否知道,一粒大米的品质与它的“内在密码”息息相关?
氨基酸赋予米饭鲜味与咀嚼弹性,糖类决定甜度与光泽,有机酸调节风味层次,而支链氨基酸则影响蛋白质结构与口感稳定性。不同产地的环境差异会显著改变这些代谢物的组成。例如,阳光充足的地区可能积累更多糖类,而特定有机酸的差异则可能成为区分“风土特色”的关键标志物。然而,传统检测方法受限于分析维度单一、操作繁琐,难以同时捕捉数十种代谢物的细微变化,导致品质评价缺乏系统性依据。
靶向代谢组学技术为这一难题提供了高效解决方案。它通过预先设定目标代谢物清单,结合三重四极杆质谱的精准定量能力,实现对目标分子的“精准追踪”。相较于传统方法,其优势在于:仅聚焦关键代谢物,避免干扰信号;一次实验可同时测定数百种成分,数据标准化程度高。
然而代谢组数据因其高维度、多变量和复杂关联性,传统统计方法常面临解释力不足的挑战。机器学习技术凭借其强大的模式识别和数据挖掘能力,能够从海量代谢组数据中发现隐藏的生物学规律,并支持分类预测(如区分样本来源)和关键代谢标志物筛选,已成为代谢组学研究的重要工具。
本研究以日本越光稻米为模型,结合岛津的LC-MS/MS硬件平台、MRM方法包及智能化数据分析软件,系统展示了代谢组学与机器学习的协同应用。通过LCMS-8060RX质谱仪的高灵敏度检测和标准化MRM方法包的快速分析,获取了覆盖氨基酸、糖类等49种代谢物的高质量数据;随后借助eMSTAT Solution软件内置的机器学习算法(如支持向量机SVM、随机森林),不仅实现了不同产地稻米代谢特征的精准分类,还通过统计模型(ANOVA、PCA)与机器学习的联合分析,识别出葡萄糖、支链氨基酸等关键差异代谢物。
LCMS-TQ RX系列进行大米中代谢产物分析
样本与实验设计
1、样本来源:选取日本6个县(新潟、富山、香川等)的8个越光稻米产地,每组样本进行5次重复实验,确保数据可靠性。
2、预处理流程:
冷冻粉碎:避免代谢物降解,提高提取效率;
甲醇提取:高效溶解极性代谢物(如氨基酸、有机酸);
内标校准:添加甲硫氨酸砜MetSO3H作为内标,消除批次差异对定量的影响。
实验技术平台与参数
1、仪器与方法:
LC-MS/MS系统:LCMS-8060RX三重四极杆质谱仪 + Nexera X3 UHPLC系统;
检测模式:MRM(多反应监测),采用ESI源(正负离子模式切换)。
2、MRM方法包:
LC-MS/MS Method Package for Primary Metabolites Ver.3;
支持141种代谢物检测,额外优化葡萄糖和蔗糖的参数(如碰撞能量、保留时间);
分析时间:40分钟完成全流程分析,显著优于传统分批检测。
3、软件支持:
LabSolutions Insight:自动批处理数据,利用内标校正峰面积,输出标准化代谢物浓度;
eMSTAT Solution:内置多元统计分析模块(PCA、ANOVA、PLS-DA)和机器学习模型(SVM、随机森林)。
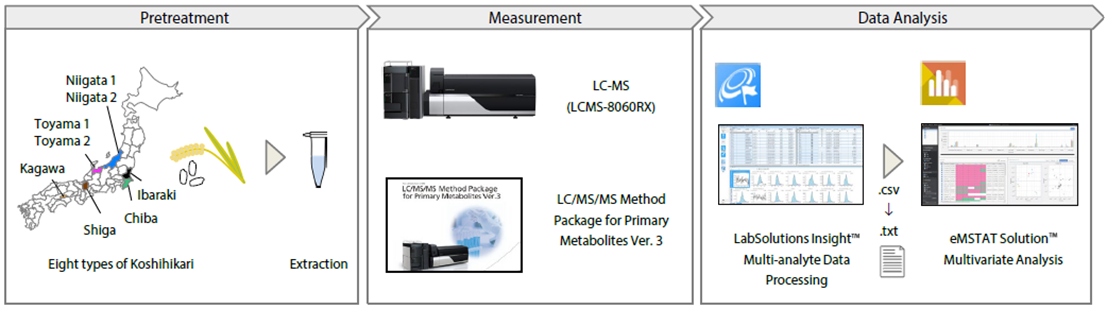
大米靶向代谢组学分析流程
eMSTAT Solution软件是岛津一款具备直观且用户友好界面的统计分析软件。它能够识别岛津色谱,质谱分析数据,支持单变量和多元分析以发现生物标志物。此外,还可通过基于已知样本数据进行机器学习从而(训练数据)构建的模型,进而可对未知样本进行判别分析。
本文采用eMSTAT Solution进行统计学分析和机器学习模型建模。
数据分析与关键结果
1、代谢物检测:成功定量49种代谢物,包括氨基酸(谷氨酸、亮氨酸)、有机酸(苹果酸、水杨酸)、糖类(葡萄糖、蔗糖)等。
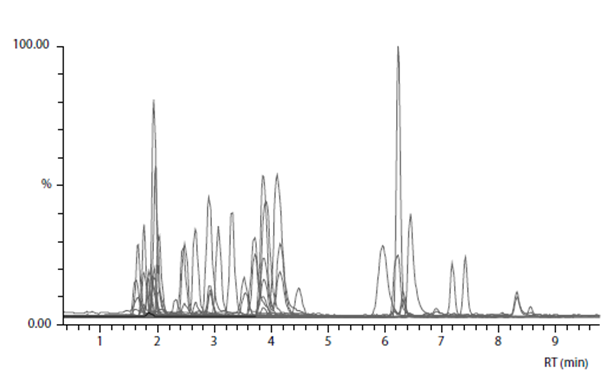
大米实际样品色谱图
2、多变量统计可视化:
显著性统计:ANOVA分析显示,45种代谢物在不同产地间差异显著(p<0.05),如:
葡萄糖:新潟样本(均值32.1 μg/g)显著低于香川样本(48.7 μg/g);
亮氨酸:富山样本含量比茨城高1.8倍,可能与当地低温促进支链氨基酸合成有关。
PCA得分图:
Score Plot显示8个产地样本在PC1(32%变异度)和PC2(28%)轴上呈现清晰聚类(如图1),说明环境因素主导代谢差异;
Loading Plot图显示蔗糖、苹果酸对组间差异贡献最大(正/负向负载值分别为+0.73和-0.68)。
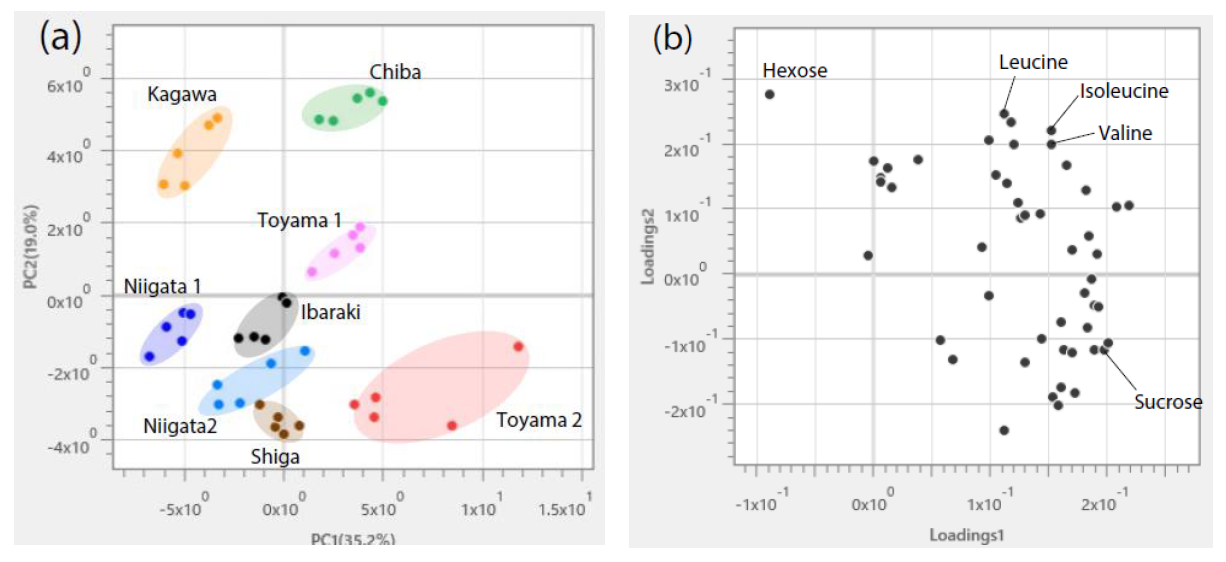
PAC分析结果Score Plot(图a),Loading Plot(图b)
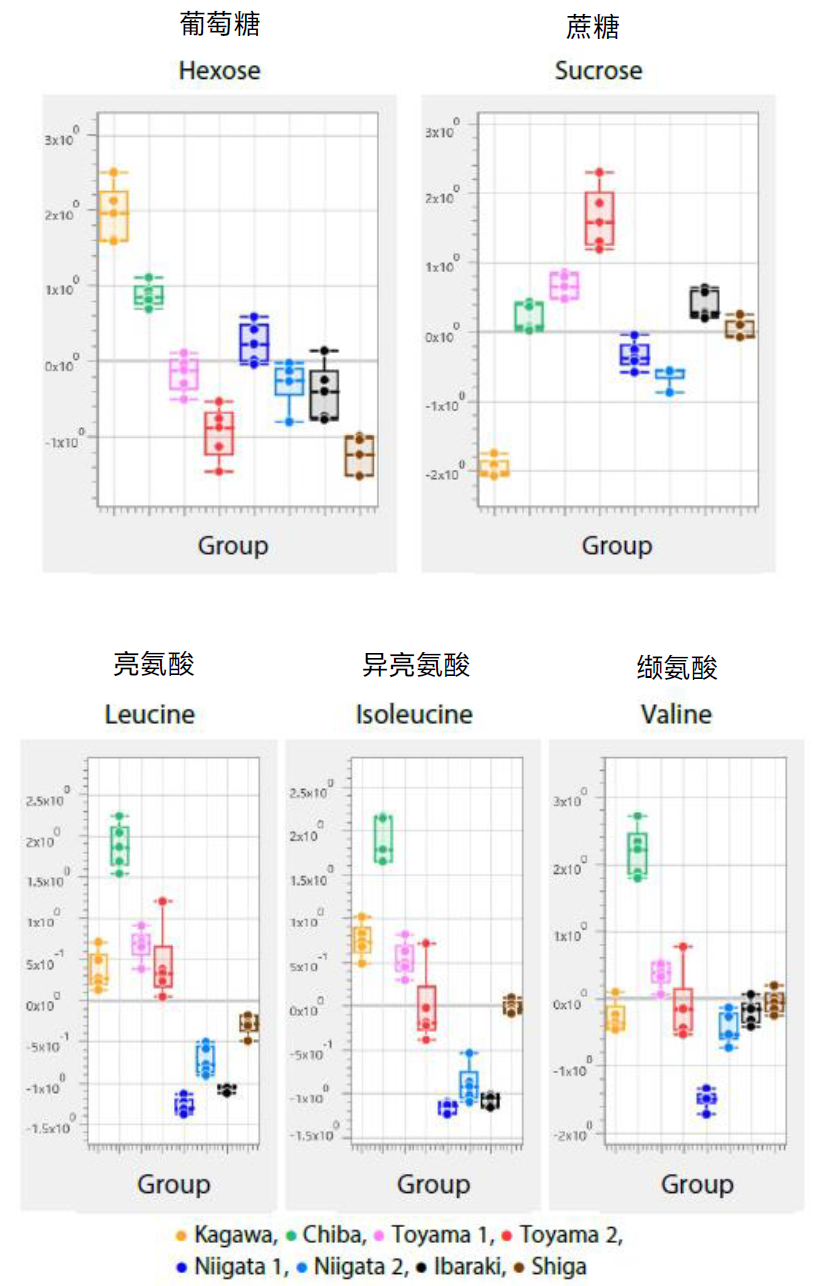
样本间特征代谢物的箱线图
3、产地分类预测:eMSTAT Solution软件
SVM(支持向量机)模型:准确率92%,可依据代谢物谱快速判断样本产地;
随机森林模型:识别出12种核心标志物(如脯氨酸、柠檬酸),其权重总和贡献85%的分类准确性。
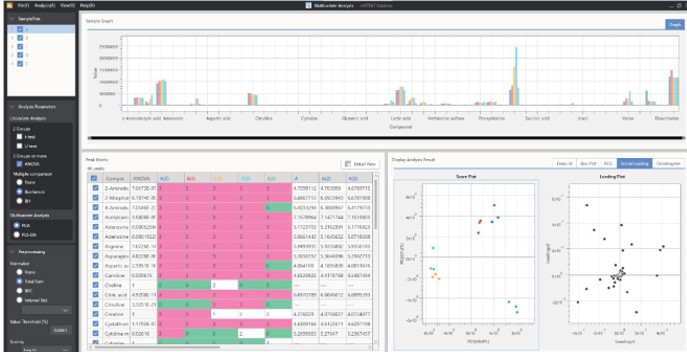
eMSTAT Solution软件分析界面
结论
本研究通过岛津完整的硬件-MRM方法包-软件一体化解决方案,高效完成了不同产地稻米代谢组学分析,充分展示了其在代谢标志物发现、地域特征评估及质量控制中的强大能力。
1、硬件设备:高灵敏度与稳定性的LC-MS/MS系统
LCMS-TQ RX三重四极杆质谱仪:
核心性能:采用CoreSpray离子源技术,确保复杂基质中代谢物的高效电离和检测,尤其对痕量成分(如某些氨基酸、有机酸)具有高灵敏度。
稳定性:在连续分析多批次样本时(如8个产地、5重复),基线噪音低,保证定量结果的重复性和准确性。
Nexera X3 HPLC系统:
高效分离能力:搭载Shim-pack GIST PFPP色谱柱,实现49种代谢物的快速分离(总运行时间短),且峰形尖锐、分离度高,避免了共洗脱干扰。
自动化兼容性:与质谱无缝对接,支持高通量分析,减少人工操作误差。
2、MRM方法包:加速代谢组学分析流程
LC-MS/MS Method Package for Primary Metabolites Ver.3:
预设参数库:包含141种主要代谢物(氨基酸、有机酸等)的MRM参数(碰撞能、碰撞电压等),可直接调用,极大缩短方法开发时间。
扩展性:允许用户自定义新增目标物(如本研究中添加的葡萄糖和蔗糖),兼容复杂分析需求。
标准化流程:确保不同实验室间数据可比性,为代谢组学研究提供可靠的质量控制基础。
3、数据分析软件:从定量到统计的全流程支持
LabSolutions Insight:
自动化定量分析:通过内标校正(甲硫氨酸砜)和峰面积归一化,快速完成多组分、多样本的定量处理,显著降低人工干预时间。
数据兼容性:支持CSV、TXT等多种格式导出,无缝对接下游统计软件。
eMSTAT Solution软件:
统计分析一体化:提供从单变量(ANOVA、t-test)到多元分析(PCA、PLS-DA)的完整工具,直观展示样品分群(Score Plot)和变量贡献(Loading Plot)。
模型构建与预测:通过SVM、随机森林等算法,可基于已知数据(如本研究的8个产地)构建分类模型,用于未知样本的快速预测。
用户友好性:拖拽式界面简化复杂分析流程,适合非统计背景的研究者使用。
4、应用拓展性:
该方案不仅适用于农产品质量评估(如区分地域特征),还可扩展至医药代谢组学(药物代谢物分析)、生物标志物发现(疾病相关代谢物筛选,仅供研究使用)等领域。
本文内容非商业广告,仅供专业人士参考。